Encontrar mejores diseños de procesos sin evaluarlos todos
Cómo usar optimización sin derivadas para comparar alternativas de equipos en modelos y simuladores de procesos
Albert Joon Lee, Woosik Kim y David E. Bernal Neira · Universidad Purdue · noviembre de 2026
El enfoque · Los experimentos · Lecciones prácticas · Referencias
Antes de optimizar un proceso, los ingenieros deben decidir qué proceso construir. ¿Qué reactores debe contener? ¿Cuántas etapas de separación? ¿Dónde deben entrar las alimentaciones? Estas decisiones determinan qué ecuaciones describen la planta, qué condiciones de operación son posibles y qué desempeño puede alcanzar el proceso.
Evaluar un solo diseño puede requerir resolver un problema de optimización en sí mismo. Para comparar dos configuraciones de reactores, por ejemplo, hay que optimizar las temperaturas, los caudales y los tamaños de los equipos de cada una. Cuando el proceso se modela con un simulador, encontrar las mejores condiciones de operación de un solo diseño exige simularlo muchas veces. Al combinar varias decisiones discretas —como el tipo y número de equipos, la cantidad de etapas o la ubicación de las alimentaciones y recirculaciones—, las alternativas se multiplican rápidamente hasta generar cientos o miles de configuraciones posibles, por lo que evaluarlas todas resulta demasiado costoso.
Nuestra nueva preimpresión (preprint), Generalized Disjunctive Programming with Derivative-Free Configuration Search [1], estudia cómo encontrar buenos diseños con menos evaluaciones. En varios problemas de prueba, los métodos de búsqueda evaluados encontraron los mejores diseños registrados después de explorar solo una pequeña parte del espacio de configuraciones. El mismo enfoque también funcionó con un simulador de procesos farmacéuticos y con un modelo de destilación catalítica en el que las formulaciones convencionales de optimización fallaron.
El modelo y la búsqueda
Describimos las decisiones de diseño mediante programación disyuntiva generalizada, o GDP por sus siglas en inglés. GDP describe las alternativas y sus relaciones lógicas: seleccionar un equipo activa sus ecuaciones; excluirlo elimina esas ecuaciones del diseño seleccionado. Las reglas permiten expresar qué decisiones requieren otras y qué combinaciones están prohibidas. Un ingeniero puede usar estas reglas para especificar qué configuraciones de equipos están permitidas.
Los métodos convencionales resuelven estos modelos combinando las alternativas en un problema de optimización no lineal entera mixta (MINLP, por sus siglas en inglés) o descomponiendo el modelo en problemas más pequeños. Sin embargo, requieren acceso a las ecuaciones que describen cada alternativa, y un simulador puede no exponer esas ecuaciones. Incluso cuando todas las ecuaciones están disponibles, la formulación combinada puede presentar dificultades numéricas.
Usamos una representación desarrollada en nuestros trabajos previos [2], [3] en la que variables enteras externas identifican las decisiones de diseño. Una configuración se convierte en un punto en un sistema de coordenadas enteras. Una vez seleccionado ese punto, fijamos las decisiones sobre los equipos y optimizamos las variables de operación restantes.
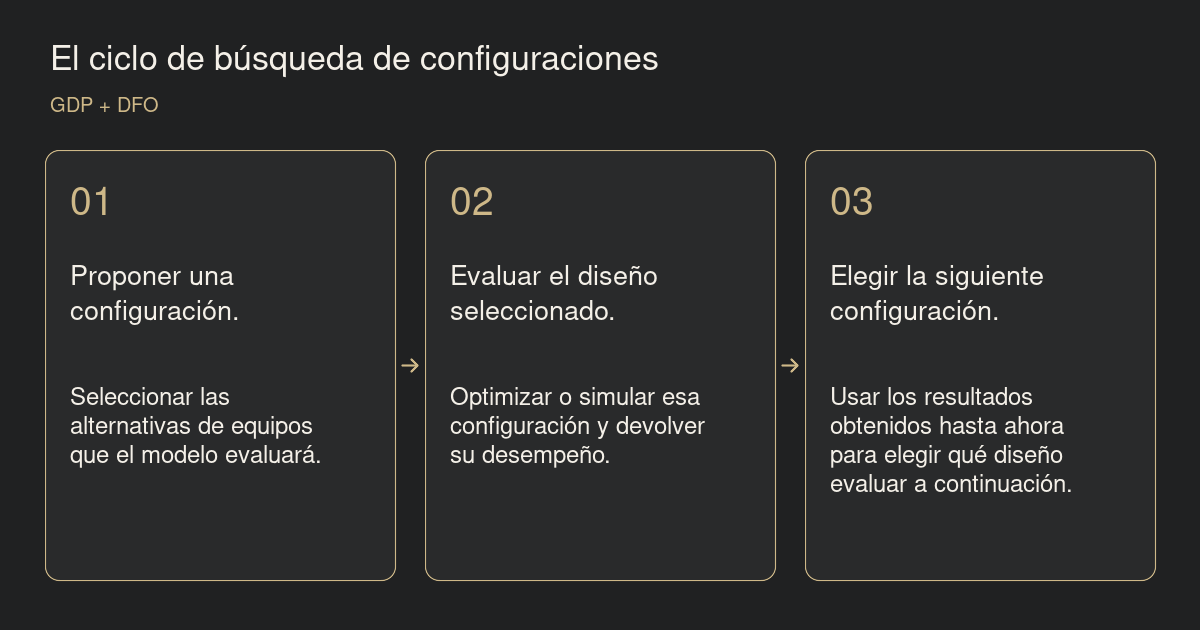
La búsqueda se realiza en tres pasos:
-
Proponer una configuración.
Seleccionar las alternativas de equipos que el modelo evaluará.
-
Evaluar el diseño seleccionado.
Optimizar o simular esa configuración y devolver su desempeño.
-
Elegir la siguiente configuración.
Usar los resultados obtenidos hasta ahora para elegir qué diseño evaluar a continuación.
Esta conexión es la contribución central de nuestro trabajo [1]: al separar el modelo lógico de la estrategia de búsqueda mediante variables enteras externas, acoplamos GDP con métodos de optimización sin derivadas (DFO, por sus siglas en inglés). El modelo GDP sigue describiendo las alternativas, su lógica y la forma en que se evalúa cada diseño, mientras que la búsqueda externa solo necesita los resultados de esas evaluaciones. Por lo tanto, cualquier método de optimización sin derivadas capaz de manejar variables enteras puede explorar estas configuraciones.
Algunos métodos exploran diseños cercanos y avanzan hacia mejoras. Otros construyen modelos surrogados: aproximaciones de bajo costo computacional de la relación entre las decisiones de diseño y el desempeño. El algoritmo puede usar estas aproximaciones para elegir entre probar diseños cercanos a un buen resultado y explorar diseños en otras zonas. Aquí, «sin derivadas» se refiere a la búsqueda externa de configuraciones; la optimización de las condiciones de operación dentro de cada configuración puede seguir utilizando derivadas.
Qué probamos
Comparamos el algoritmo de descenso local discreto (D-SDA) desarrollado en nuestros trabajos previos [2], [3], la búsqueda directa (NOMAD), varios métodos con modelos surrogados (RBFOpt, MISO, BAM y FMQA-SA) y el muestreo uniforme, junto con métodos convencionales de GDP (GDPopt y reformulaciones MINLP) y la enumeración completa. Los experimentos incluyeron nueve modelos de procesos, 21 funciones matemáticas de prueba, una simulación de fabricación farmacéutica y una columna de destilación catalítica. Los tres casos siguientes muestran cómo se comparan los métodos cuando las evaluaciones son costosas, el modelo proviene de un simulador o los solucionadores convencionales tienen dificultades.
Menos resoluciones para una red de reactores
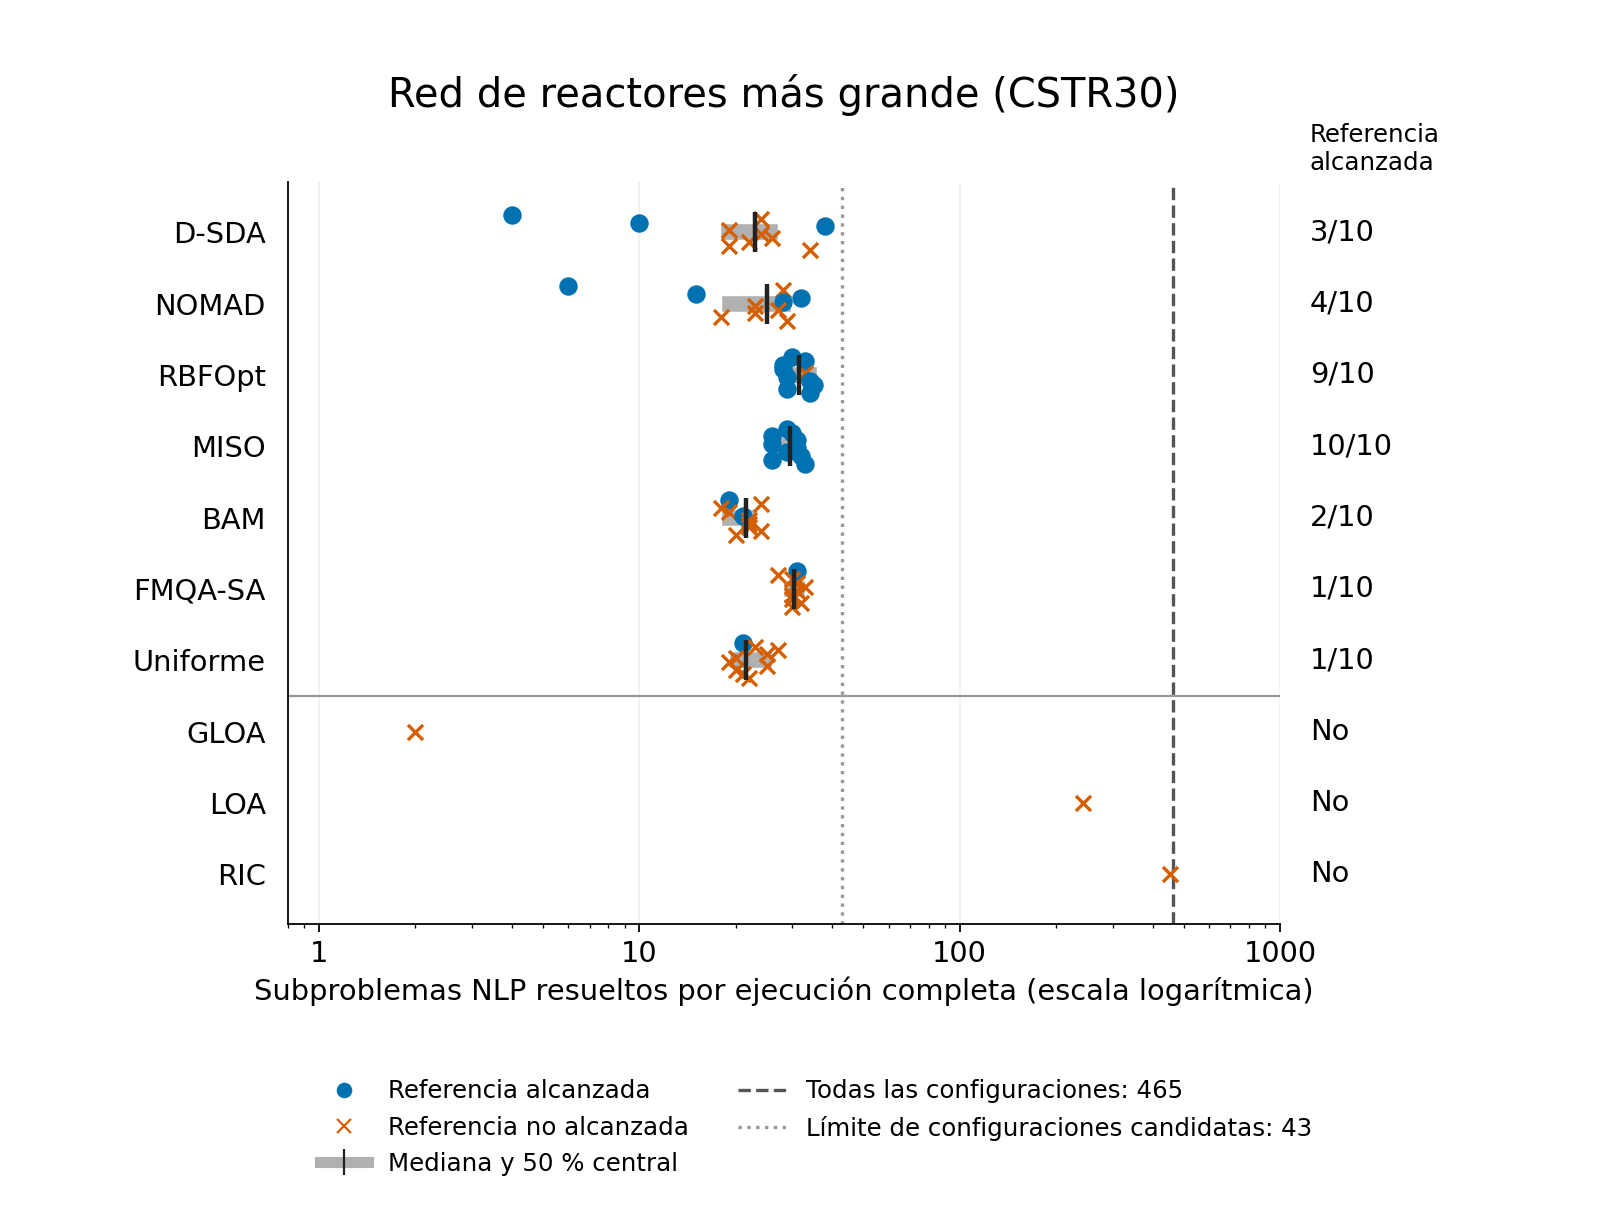
El primero es una superestructura de reactores de tanque agitado continuo (CSTR, por sus siglas en inglés) en serie que habíamos estudiado en trabajos anteriores [2], [3]. Sus decisiones de diseño incluyen cuántos reactores usar y dónde entran o se recirculan las corrientes. Este sistema sirve como un buen ejemplo porque la teoría de reactores nos dice de antemano cuál debe ser la solución: para minimizar el volumen total, la cascada debe aproximarse a un reactor de flujo pistón (PFR, por sus siglas en inglés), utilizando todos los reactores disponibles en serie y devolviendo la recirculación al primer reactor en la dirección del flujo. La red más grande de nuestro estudio tiene 465 configuraciones admisibles. Evaluarlas todas requiere resolver 465 subproblemas de optimización continua.
Los métodos con modelos surrogados MISO y RBFOpt alcanzaron el valor de referencia de la función objetivo en las diez ejecuciones y en nueve de las diez, respectivamente, con una mediana de aproximadamente 30 subproblemas resueltos. Eso representa aproximadamente el 6–7% del trabajo necesario para la enumeración.
El registro de los diseños que evaluó cada método ayuda a explicar la diferencia. En las redes más grandes, el descenso local (D-SDA) se estancó repetidamente en la misma configuración de menor calidad. Los cambios cercanos no ofrecían mejoras, aunque existía un diseño mejor en otra parte. En la red más grande, este mínimo local era aproximadamente un 13% peor que la referencia. Dar a un método de descenso un mayor presupuesto de evaluaciones tuvo poco efecto una vez que se había detenido allí.
RBFOpt y MISO podían proponer configuraciones alejadas de su mejor diseño hasta ese momento. Así podían probar diseños a los que el descenso local no llegaría mediante una secuencia de cambios que mejoraran el resultado.
Trabajar con un simulador de procesos
El segundo ejemplo es un proceso de fabricación del fármaco anticancerígeno lomustina. En nuestro trabajo previo sobre este proceso [4], incluso aplicamos solucionadores basados en modelos de Ising y recocido cuántico (quantum annealing) para ayudar a resolver el problema discreto de diseño. Aquí, distintas combinaciones de reactores y cristalizadores definen 36 diagramas de flujo de proceso posibles. Su comportamiento se evalúa con el simulador de procesos PharmaPy.
Para este problema, el simulador proporciona los resultados de operar un diseño, mientras que las ecuaciones explícitas que requieren los solucionadores algebraicos convencionales de GDP no están disponibles. La búsqueda de configuraciones puede continuar de todos modos: elegir los equipos, optimizar su operación mediante simulación y devolver el desempeño resultante.
Con un presupuesto de 20 evaluaciones de configuraciones, RBFOpt y MISO encontraron la mejor configuración registrada en las diez ejecuciones. La optimización de la operación de cada configuración tomó minutos, por lo que el costo de elegir el siguiente diseño fue pequeño en relación con el de evaluarlo.
Los ingenieros pueden usar un simulador de procesos existente para comparar alternativas de equipos sin traducir sus ecuaciones a una formulación algebraica de GDP.
Una columna con más de 100,000 configuraciones
El tercer ejemplo combina reacción química y separación en una columna de destilación catalítica para producir etil ter-butil éter (ETBE). Hemos trabajado en este sistema desde la tesis de maestría de David E. Bernal Neira en la Universidad de los Andes [5] y la tesis doctoral de su entonces asesor, Jorge Mario Gómez, así como en estudios posteriores de diseño, control y optimización de superestructuras [6], [7]. Su diseño incluye decisiones sobre las ubicaciones de las alimentaciones, las etapas catalíticas y la estructura de la columna. El modelo GDP completo contiene 100,947 configuraciones. Realizamos la búsqueda en un dominio restringido con 54,159 configuraciones admisibles, lo suficientemente grande como para que evaluar cada diseño siguiera siendo costoso.
Con un presupuesto de 100 evaluaciones, D-SDA y MISO alcanzaron cada uno el mejor diseño conocido en tres de las diez ejecuciones. Alcanzar esa referencia fue poco frecuente, pero muchas ejecuciones terminaron cerca. Las medianas de los resultados de D-SDA, NOMAD y MISO quedaron dentro de un margen del 0.14% respecto del mejor valor conocido de la función objetivo tras evaluar aproximadamente el 0.2% del dominio de búsqueda.
El descenso local fue competitivo en este caso porque los cambios hacia configuraciones cercanas a menudo conducían a buenos diseños. En las redes de reactores, en cambio, el descenso local se detuvo repetidamente en un diseño de menor calidad que no tenía ningún vecino que ofreciera una mejora.
Las formulaciones convencionales no lineales enteras mixtas encontraron dificultades más graves. Desde el punto inicial publicado, ninguno de los solucionadores probados encontró un diseño a menos del 15% de la referencia en las condiciones reportadas. Las comprobaciones adicionales produjeron declaraciones de infactibilidad contradichas por diseños factibles y certificados de optimalidad global contradichos por soluciones mejores.
Una explicación plausible es la carga numérica de mantener las ecuaciones de todas las etapas y posiciones de catalizador posibles en una formulación combinada. Las ecuaciones asociadas con equipos ausentes pueden seguir generando dificultades en las relajaciones del solucionador. Evaluar una configuración fija nos permite resolver únicamente las ecuaciones que pertenecen a ese diseño. En estos experimentos, los diseños individuales pudieron evaluarse con éxito incluso cuando las formulaciones combinadas resultaron poco confiables.
Elegir un método de búsqueda
El costo de una evaluación afecta qué método de búsqueda conviene usar. Construir y actualizar un modelo surrogado toma tiempo. Si una configuración puede evaluarse casi al instante, ese costo adicional puede superar el ahorro de evaluaciones. Para los modelos algebraicos pequeños de nuestro estudio, la enumeración o una reformulación convencional solía ser la opción más sencilla y rápida. Si cada evaluación toma minutos, el tiempo adicional dedicado a elegir el siguiente diseño puede ser pequeño en comparación con el tiempo que se ahorra al evitar evaluaciones.
La forma de numerar las alternativas de equipos también afecta la búsqueda. Las coordenadas enteras definen qué configuraciones parecen cercanas entre sí. Para decisiones con un orden natural, como el número de etapas, las coordenadas vecinas corresponden a diseños físicamente similares; aprovechar esa estructura ordenada fue precisamente la idea central de la reformulación con variables externas propuesta en nuestro anterior trabajo [3]. Para categorías como los tipos de reactores, el orden asignado puede ser arbitrario. Reordenar esas alternativas cambió el comportamiento de varios métodos en los experimentos de lomustina. Por lo tanto, al comparar métodos de búsqueda se debe revisar el orden de las alternativas categóricas.
El número de ejecuciones que alcanzan un valor de referencia de la función objetivo es solo una medida del desempeño. Un método puede no alcanzar un objetivo estricto y, aun así, producir de manera consistente diseños lo suficientemente cercanos para un estudio de ingeniería. La comparación de métodos debe incluir la calidad y la variabilidad de sus diseños finales, el número de evaluaciones y el costo computacional total.
Límites de la comparación
La mayoría de los problemas de prueba utilizaron respuestas de configuraciones almacenadas para comparar estrategias de búsqueda; en el caso de la columna catalítica, las configuraciones nuevas solicitadas se evaluaron durante la búsqueda. La optimización continua de una configuración puede devolver una solución local. Nuestras comparaciones utilizaron un número limitado de ejecuciones repetidas, y la referencia de la columna catalítica es el mejor diseño encontrado, sin una prueba confiable de optimalidad global.
Qué probar a continuación
Estos experimentos nos dan razones para elegir distintos métodos según el modelo del proceso. Cuando hay pocas configuraciones y las evaluaciones son baratas, conviene empezar con la enumeración o una reformulación convencional. Cuando los cambios cercanos conducen a buenos diseños, el descenso local puede funcionar bien. Cuando cada evaluación es costosa y el descenso local se detiene repetidamente en diseños de menor calidad, conviene considerar un método con un modelo surrogado que pueda probar configuraciones más alejadas.
Un simulador puede proporcionar las evaluaciones sin exponer todas sus ecuaciones. Si una formulación combinada es difícil de resolver, evaluar las configuraciones seleccionadas por separado puede producir diseños útiles. En ambos casos, se debe comparar la calidad de los diseños encontrados y el tiempo total empleado en encontrarlos.
Presentaciones relacionadas en AIChE
Los programas de las reuniones anuales de AIChE incluyen la presentación anterior sobre GDP y optimización sin derivadas, junto con otras dos charlas relacionadas de Albert Lee:
- Integration of Derivative Free Optimization with Logic-Based Solutions of Generalized Disjunctive Programming — Reunión Anual de 2025, presentación 531b.
- Discrete Nonlinear Algorithms for Process Design and Operations — Reunión Anual de 2026, presentación 484a.
- Generalized Disjunctive Programming Via Factorization Machines and Quantum Annealers — Reunión Anual de 2026, presentación 608g.